上游地址(听风全网首发详细玩法):
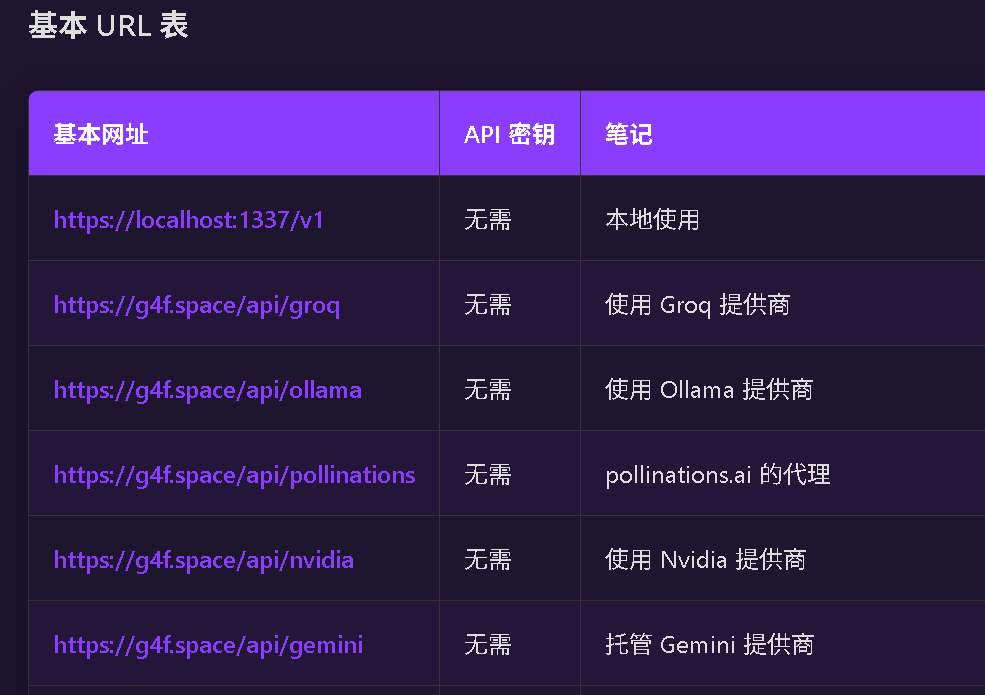
url:
自己去上游看看
key:
不用key
模型列表:

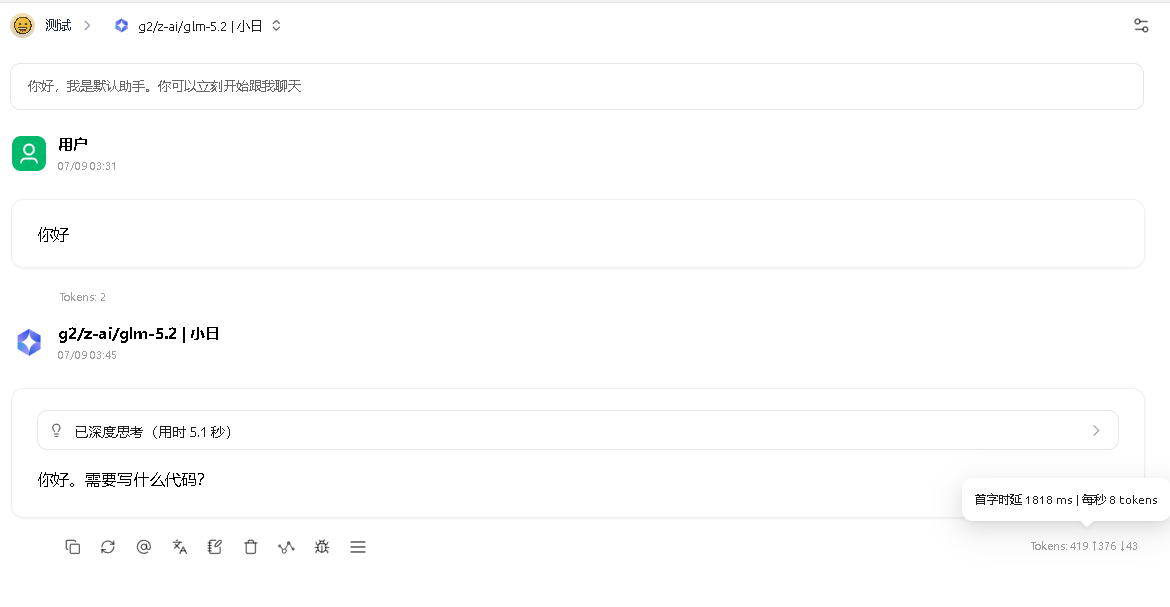
对话效果
不同端点有不同的模型列表:

有些获取不到模型列表,那么后面就要带v1的
英伟达的这个端点如果说获取不到模型列表你可以照着我下面的这个来:

这是为您将 JSON 数据转换成的 Markdown 表格:
| 模型 ID | 类型 | 创建时间 | 所有者 | 请求数 |
|---|---|---|---|---|
| nvidia/nemotron-3-nano-30b-a3b | model | 735790403 | nvidia | 455 |
| minimaxai/minimax-m2.7 | model | 735790403 | minimaxai | 339 |
| moonshotai/kimi-k2.6 | model | 735790403 | moonshotai | 229 |
| meta/llama-3.1-8b-instruct | model | 735790403 | meta | 168 |
| z-ai/glm-5.2 | model | 735790403 | z-ai | 161 |
| stepfun-ai/step-3.7-flash | model | 735790403 | stepfun-ai | 118 |
| nvidia/nemotron-3-super-120b-a12b | model | 735790403 | nvidia | 110 |
| meta/llama-3.1-70b-instruct | model | 735790403 | meta | 93 |
| minimaxai/minimax-m3 | model | 735790403 | minimaxai | 74 |
| deepseek-ai/deepseek-v4-pro | model | 735790403 | deepseek-ai | 67 |
| openai/gpt-oss-120b | model | 735790403 | openai | 44 |
| google/diffusiongemma-26b-a4b-it | model | 735790403 | 43 | |
| mistralai/mistral-small-4-119b-2603 | model | 735790403 | mistralai | 22 |
| mistralai/mistral-large-3-675b-instruct-2512 | model | 735790403 | mistralai | 19 |
| deepseek-ai/deepseek-v4-flash | model | 735790403 | deepseek-ai | 16 |
| stepfun-ai/step-3.5-flash | model | 735790403 | stepfun-ai | 16 |
| meta/llama-3.2-11b-vision-instruct | model | 735790403 | meta | 15 |
| meta/llama-3.3-70b-instruct | model | 735790403 | meta | 8 |
| meta/llama-4-maverick-17b-128e-instruct | model | 735790403 | meta | 8 |
| nvidia/llama-3.3-nemotron-super-49b-v1.5 | model | 735790403 | nvidia | 8 |
| openai/gpt-oss-20b | model | 735790403 | openai | 6 |
| nvidia/nemotron-3-nano-omni-30b-a3b-reasoning | model | 735790403 | nvidia | 5 |
| meta/llama-3.2-90b-vision-instruct | model | 735790403 | meta | 4 |
| meta/llama-guard-4-12b | model | 735790403 | meta | 4 |
| nvidia/nemotron-3-ultra-550b-a55b | model | 735790403 | nvidia | 3 |
| nvidia/riva-translate-4b-instruct-v1.1 | model | 735790403 | nvidia | 3 |
| abacusai/dracarys-llama-3.1-70b-instruct | model | 735790403 | abacusai | 2 |
| mistralai/mistral-medium-3.5-128b | model | 735790403 | mistralai | 2 |
| nvidia/nemotron-content-safety-reasoning-4b | model | 735790403 | nvidia | 2 |
| qwen/qwen3.5-397b-a17b | model | 735790403 | qwen | 2 |
| meta/llama-3.2-1b-instruct | model | 735790403 | meta | 1 |
| mistralai/ministral-14b-instruct-2512 | model | 735790403 | mistralai | 1 |
| mistralai/mixtral-8x7b-instruct-v0.1 | model | 735790403 | mistralai | 1 |
| nvidia/gliner-pii | model | 735790403 | nvidia | 1 |
| nvidia/ising-calibration-1-35b-a3b | model | 735790403 | nvidia | 1 |
| nvidia/nemotron-3.5-content-safety | model | 735790403 | nvidia | 1 |
| nvidia/nvidia-nemotron-nano-9b-v2 | model | 735790403 | nvidia | 1 |
| sarvamai/sarvam-m | model | 735790403 | sarvamai | 1 |
| 01-ai/yi-large | model | 735790403 | 01-ai | - |
| adept/fuyu-8b | model | 735790403 | adept | - |
| ai21labs/jamba-1.5-large-instruct | model | 735790403 | ai21labs | - |
| aisingapore/sea-lion-7b-instruct | model | 735790403 | aisingapore | - |
| baai/bge-m3 | model | 735790403 | baai | - |
| bigcode/starcoder2-15b | model | 735790403 | bigcode | - |
| bytedance/seed-oss-36b-instruct | model | 735790403 | bytedance | - |
| databricks/dbrx-instruct | model | 735790403 | databricks | - |
| deepseek-ai/deepseek-coder-6.7b-instruct | model | 735790403 | deepseek-ai | - |
| google/codegemma-1.1-7b | model | 735790403 | - | |
| google/codegemma-7b | model | 735790403 | - | |
| google/deplot | model | 735790403 | - | |
| google/gemma-2-2b-it | model | 735790403 | - | |
| google/gemma-2b | model | 735790403 | - | |
| google/gemma-3-12b-it | model | 735790403 | - | |
| google/gemma-3-4b-it | model | 735790403 | - | |
| google/gemma-3n-e2b-it | model | 735790403 | - | |
| google/gemma-3n-e4b-it | model | 735790403 | - | |
| google/gemma-4-31b-it | model | 735790403 | - | |
| google/recurrentgemma-2b | model | 735790403 | - | |
| ibm/granite-3.0-3b-a800m-instruct | model | 735790403 | ibm | - |
| ibm/granite-3.0-8b-instruct | model | 735790403 | ibm | - |
| ibm/granite-34b-code-instruct | model | 735790403 | ibm | - |
| ibm/granite-8b-code-instruct | model | 735790403 | ibm | - |
| meta/codellama-70b | model | 735790403 | meta | - |
| meta/llama-3.2-3b-instruct | model | 735790403 | meta | - |
| meta/llama2-70b | model | 735790403 | meta | - |
| microsoft/kosmos-2 | model | 735790403 | microsoft | - |
| microsoft/phi-3-vision-128k-instruct | model | 735790403 | microsoft | - |
| microsoft/phi-3.5-moe-instruct | model | 735790403 | microsoft | - |
| microsoft/phi-4-mini-instruct | model | 735790403 | microsoft | - |
| microsoft/phi-4-multimodal-instruct | model | 735790403 | microsoft | - |
| mistralai/codestral-22b-instruct-v0.1 | model | 735790403 | mistralai | - |
| mistralai/mistral-7b-instruct-v0.3 | model | 735790403 | mistralai | - |
| mistralai/mistral-large | model | 735790403 | mistralai | - |
| mistralai/mistral-large-2-instruct | model | 735790403 | mistralai | - |
| mistralai/mistral-nemotron | model | 735790403 | mistralai | - |
| mistralai/mixtral-8x22b-v0.1 | model | 735790403 | mistralai | - |
| nv-mistralai/mistral-nemo-12b-instruct | model | 735790403 | nv-mistralai | - |
| nvidia/ai-synthetic-video-detector | model | 735790403 | nvidia | - |
| nvidia/cosmos-reason2-8b | model | 735790403 | nvidia | - |
| nvidia/embed-qa-4 | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemoguard-8b-content-safety | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemoguard-8b-topic-control | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-51b-instruct | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-70b-instruct | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-nano-8b-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-nano-vl-8b-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-safety-guard-8b-v3 | model | 735790403 | nvidia | - |
| nvidia/llama-3.1-nemotron-ultra-253b-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-3.2-nemoretriever-1b-vlm-embed-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-3.2-nv-embedqa-1b-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-3.3-nemotron-super-49b-v1 | model | 735790403 | nvidia | - |
| nvidia/llama-nemotron-embed-1b-v2 | model | 735790403 | nvidia | - |
| nvidia/llama-nemotron-embed-vl-1b-v2 | model | 735790403 | nvidia | - |
| nvidia/llama3-chatqa-1.5-70b | model | 735790403 | nvidia | - |
| nvidia/mistral-nemo-minitron-8b-8k-instruct | model | 735790403 | nvidia | - |
| nvidia/nemoretriever-parse | model | 735790403 | nvidia | - |
| nvidia/nemotron-3-content-safety | model | 735790403 | nvidia | - |
| nvidia/nemotron-4-340b-instruct | model | 735790403 | nvidia | - |
| nvidia/nemotron-4-340b-reward | model | 735790403 | nvidia | - |
| nvidia/nemotron-mini-4b-instruct | model | 735790403 | nvidia | - |
| nvidia/nemotron-nano-12b-v2-vl | model | 735790403 | nvidia | - |
| nvidia/nemotron-nano-3-30b-a3b | model | 735790403 | nvidia | - |
| nvidia/nemotron-parse | model | 735790403 | nvidia | - |
| nvidia/neva-22b | model | 735790403 | nvidia | - |
| nvidia/nv-embed-v1 | model | 735790403 | nvidia | - |
| nvidia/nv-embedcode-7b-v1 | model | 735790403 | nvidia | - |
| nvidia/nv-embedqa-e5-v5 | model | 735790403 | nvidia | - |
| nvidia/nv-embedqa-mistral-7b-v2 | model | 735790403 | nvidia | - |
| nvidia/nvclip | model | 735790403 | nvidia | - |
| nvidia/riva-translate-4b-instruct | model | 735790403 | nvidia | - |
| nvidia/vila | model | 735790403 | nvidia | - |
| qwen/qwen3-next-80b-a3b-instruct | model | 735790403 | qwen | - |
| qwen/qwen3.5-122b-a10b | model | 735790403 | qwen | - |
| snowflake/arctic-embed-l | model | 735790403 | snowflake | - |
| stockmark/stockmark-2-100b-instruct | model | 735790403 | stockmark | - |
| upstage/solar-10.7b-instruct | model | 735790403 | upstage | - |
| writer/palmyra-creative-122b | model | 735790403 | writer | - |
| writer/palmyra-fin-70b-32k | model | 735790403 | writer | - |
| writer/palmyra-med-70b | model | 735790403 | writer | - |
| writer/palmyra-med-70b-32k | model | 735790403 | writer | - |
| zyphra/zamba2-7b-instruct | model | 735790403 | zyphra | - |
然后呢groq的端点:
| 模型名称 | 模型 ID | 所有者 | 上下文长度 | 模态 (输入 ➔ 输出) | 支持特性 | 请求数 |
|---|---|---|---|---|---|---|
| Llama 4 Scout 17B 16E | meta-llama/llama-4-scout-17b-16e-instruct | Meta | 131,072 | text, image ➔ text | tools, json_mode | 631 |
| Llama 3.1 8B | llama-3.1-8b-instant | Meta | 131,072 | text ➔ text | tools, json_mode | 602 |
| GPT OSS 120B | openai/gpt-oss-120b | OpenAI | 131,072 | text ➔ text | tools, json_mode, structured_outputs, reasoning | 210 |
| GPT OSS 20B | openai/gpt-oss-20b | OpenAI | 131,072 | text ➔ text | tools, json_mode, structured_outputs, reasoning | 202 |
| Llama 3.3 70B | llama-3.3-70b-versatile | Meta | 131,072 | text ➔ text | tools, json_mode | 101 |
| Qwen3-32B | qwen/qwen3-32b | Alibaba Cloud | 131,072 | text ➔ text | tools, json_mode, reasoning | 98 |
| Qwen/Qwen3.6-27B | qwen/qwen3.6-27b | Alibaba Cloud | 131,072 | text, image ➔ text | tools, json_mode, reasoning | 21 |
| Compound | groq/compound | Groq | 131,072 | text ➔ text | json_mode | 9 |
| Compound Mini | groq/compound-mini | Groq | 131,072 | text ➔ text | json_mode | 5 |
| ALLaM-2-7b | allam-2-7b | SDAIA | 4,096 | text ➔ text | json_mode | 2 |
| Safety GPT OSS 20B | openai/gpt-oss-safeguard-20b | OpenAI | 131,072 | text ➔ text | tools, json_mode, structured_outputs, reasoning | 1 |
| Orpheus V1 English | canopylabs/orpheus-v1-english | Canopy Labs | 4,000 | text ➔ speech | - | - |
| Orpheus Arabic Saudi | canopylabs/orpheus-arabic-saudi | Canopy Labs | 4,000 | text ➔ speech | - | - |
| Whisper Large V3 Turbo | whisper-large-v3-turbo | OpenAI | 448 | audio ➔ transcription | - | - |
| Whisper | whisper-large-v3 | OpenAI | 448 | audio ➔ transcription | - | - |
| Prompt Guard 2 86M | meta-llama/llama-prompt-guard-2-86m | Meta | 512 | text ➔ text | json_mode | - |
| Llama Prompt Guard 2 22M | meta-llama/llama-prompt-guard-2-22m | Meta | 512 | text ➔ text | - | - |
(注:部分音频/安全/特殊模型未提供 requests 或 supported_features 字段,故以 - 表示。)
ollama端点:
| 模型名称 (Name) | 模型 ID | 模型大小 | 最后修改日期 | 请求数 |
|---|---|---|---|---|
| gemma4:31b | gemma4:31b | 58.25 GB | 2026-04-02 | 453 |
| nemotron-3-super | nemotron-3-super | 214.67 GB | 2026-03-11 | 322 |
| nemotron-3-nano:30b | nemotron-3-nano:30b | 30.40 GB | 2025-12-15 | 74 |
| gemma3:27b | gemma3:27b | 51.22 GB | 2025-03-12 | 72 |
| ministral-3:3b | ministral-3:3b | 4.35 GB | 2025-12-02 | 45 |
| gpt-oss:120b | gpt-oss:120b | 60.81 GB | 2025-08-05 | 41 |
| glm-4.7 | glm-4.7 | 648.26 GB | 2025-12-22 | 32 |
| gemma3:12b | gemma3:12b | 22.35 GB | 2025-03-12 | 19 |
| gpt-oss:20b | gpt-oss:20b | 12.83 GB | 2025-08-05 | 19 |
| qwen3-coder-next | qwen3-coder-next | 76.18 GB | 2025-02-04 | 4 |
| ministral-3:14b | ministral-3:14b | 14.62 GB | 2025-12-02 | 4 |
| ministral-3:8b | ministral-3:8b | 9.69 GB | 2025-12-02 | 3 |
| minimax-m2.5 | minimax-m2.5 | 214.20 GB | 2026-02-12 | 2 |
| gemma3:4b | gemma3:4b | 8.01 GB | 2025-03-12 | 2 |
| devstral-2:123b | devstral-2:123b | 119.44 GB | 2025-12-08 | 2 |
| devstral-small-2:24b | devstral-small-2:24b | 48.06 GB | 2025-12-09 | 1 |
| minimax-m2.1 | minimax-m2.1 | 214.20 GB | 2025-12-20 | - |
(注:glm-4.7 的模型体积异常庞大,达到了 648 GB,可能是包含了未量化的全精度权重或特殊的庞大架构;最后一项 minimax-m2.1 缺少请求数统计,故用 - 表示。)